- U-Net (2015) → 기본 구조 이해
- DeepLabV3+ (2018) → segmentation 발전
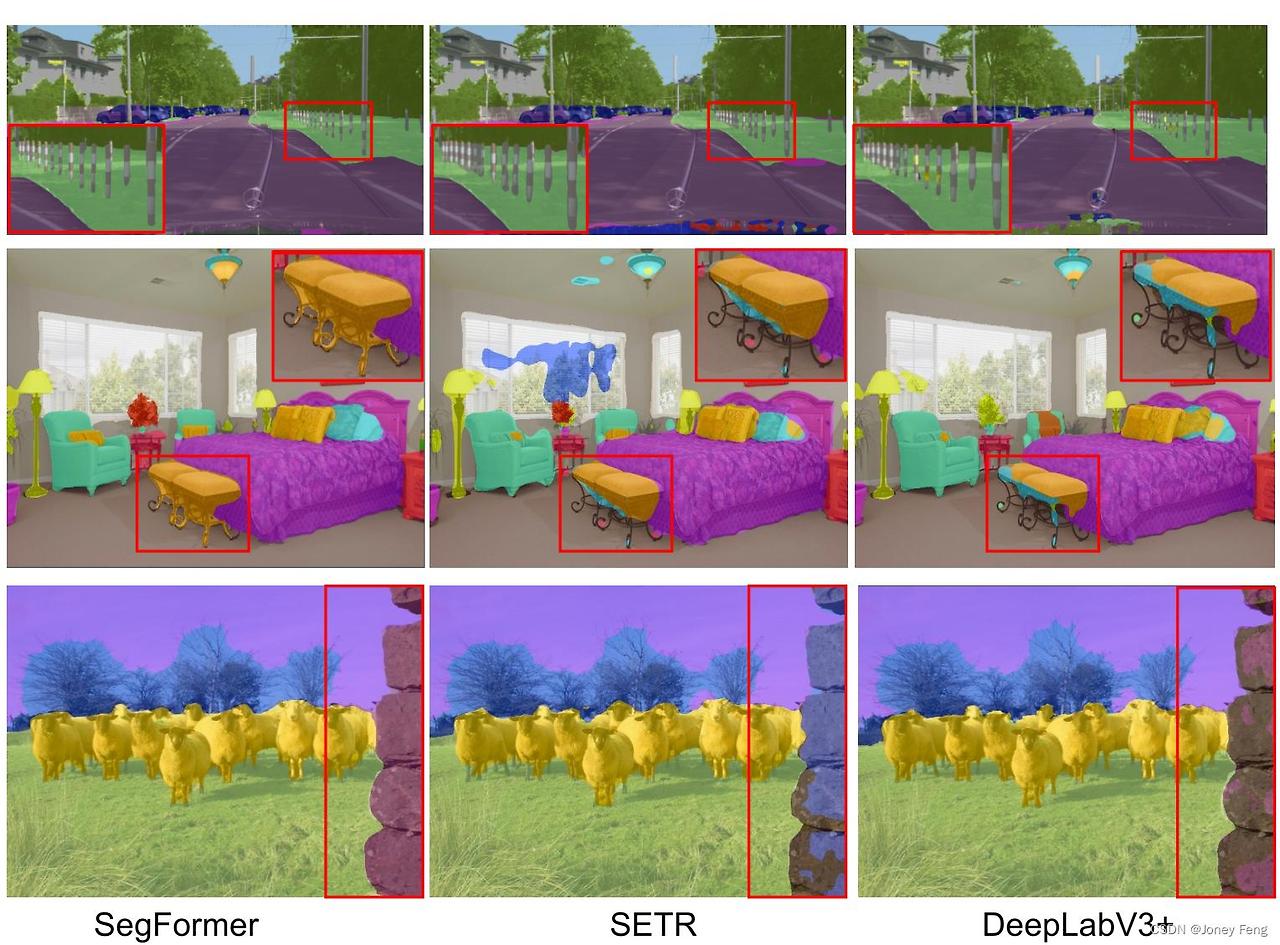
- SegFormer (2021) → Transformer 기반
- LoveDA Dataset Paper → Remote Sensing segmentation
- ISPRS Vaihingen/Potsdam benchmark papers
- Spatial Regularization 관련 TGRS/ISPRS 논문
- Multi-modal Remote Sensing (RGB+DEM, RGB+SAR 등) 논문
단계꼭 읽을 논문 (1편)왜 읽는가?읽을 때 집중할 질문
| 1. Segmentation의 시작 | U-Net: Convolutional Networks for Biomedical Image Segmentation | Semantic Segmentation의 기본 철학 | 입력→Encoder→Decoder→Loss가 어떻게 연결되는가? |
| 2. CNN의 발전 | Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation | 현재 CNN 기반 segmentation의 대표 모델 | 공간 정보를 어떻게 추출하는가? Loss는 무엇인가? |
| 3. Transformer 시대 | SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers | CNN 이후 segmentation의 흐름 | Attention이 공간 정보를 어떻게 활용하는가? |
| 4. Remote Sensing 대표 데이터셋 | LoveDA: A Remote Sensing Land-Cover Dataset for Domain Adaptive Semantic Segmentation | RS segmentation에서 무엇이 어려운지 이해 | 왜 일반 segmentation보다 어려운가? |
| 5. Benchmark | The ISPRS 2D Semantic Labeling Contest | 어떤 모델들이 경쟁하는지 | 현재 SOTA들은 무엇을 비교하는가? |
| 6. Spatial-aware Learning | Conditional Random Fields as Recurrent Neural Networks | 공간 제약을 학습에 반영한 대표 사례 | 공간 관계를 어디에서 사용하는가? (후처리? 학습?) |
| 7. Multi-modal Remote Sensing | CMGFNet: Cross-Modal Gated Fusion Network for RGB-DEM Semantic Segmentation | 멀티모달 공간 데이터 융합 | 단순 Fusion인지, 학습 과정까지 바꾸는지 |
U-Net: Convolutional Networks for Biomedical Image Segmentation
U-Net: Convolutional Networks for Biomedical Image Segmentation는 2015년에 발표된 딥러닝 분야의 대표적인 연구 논문으로, 생체의료 영상 분할(biomedical image segmentation)을 위한 U자 형태의 합성곱 신경망(CNN) 구조를 제안했다. 제한된 학습 데이터만으로도 높은 성능을 달성하는 설계 덕분에 의료 영상 분석뿐 아니라 다양한 컴퓨터 비전 분야의 표준 기반 모델로 자리 잡았다.
핵심 내용
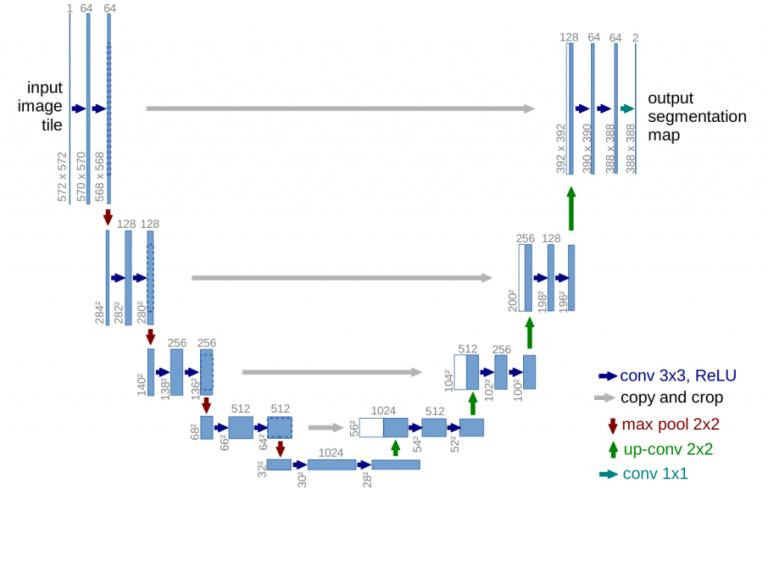
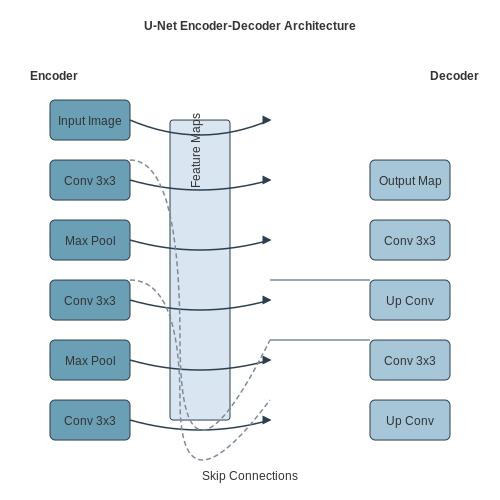
이 논문의 가장 중요한 기여는 인코더(Encoder)와 디코더(Decoder)를 결합한 U자형 네트워크와, 대응되는 계층을 직접 연결하는 스킵 연결(skip connections)이다. 인코더는 이미지의 의미 정보를 추출하고, 디코더는 공간 해상도를 복원하며, 스킵 연결은 세밀한 위치 정보를 보존해 픽셀 단위의 정확한 분할을 가능하게 한다.
왜 중요한가
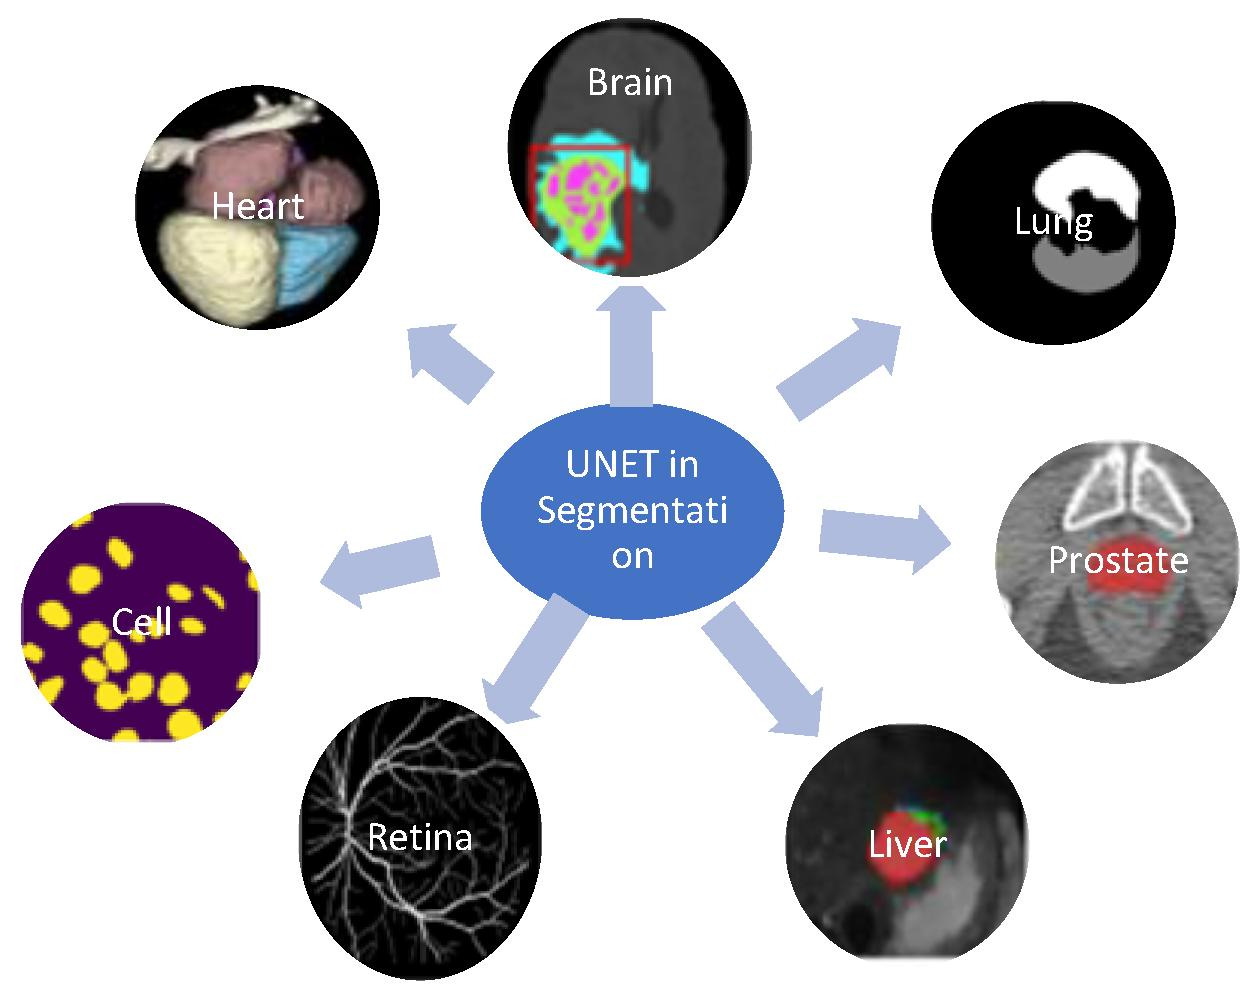
발표 당시 많은 의료 영상 데이터셋은 크기가 작고, 픽셀 단위의 정답(레이블)을 만드는 비용도 매우 높았다. 이 논문은 강력한 데이터 증강 기법과 효율적인 네트워크 구조를 함께 제안하여 적은 학습 데이터에서도 뛰어난 성능을 보여 주었고, 세포, 조직, 장기 등의 자동 분할 문제에서 큰 영향을 미쳤다. 이후 위성영상, 자율주행, 산업 검사, 문서 분석 등 픽셀 단위 예측이 필요한 다양한 분야로 활용 범위가 크게 확장되었다.
구조와 특징
U-Net은 좌측의 수축 경로(contracting path)에서 특징을 추출하고, 우측의 확장 경로(expanding path)에서 해상도를 복원한다. 각 단계의 대응 계층을 연결하는 스킵 연결은 고수준 의미 정보와 저수준 공간 정보를 함께 활용하도록 하여 경계 표현을 개선하며, 이 구조는 오늘날 수많은 U-Net 변형 모델의 출발점이 되었다.
영향과 후속 연구
U-Net은 의료 AI 분야에서 가장 많이 인용되는 모델 가운데 하나이며, 이후 3D U-Net, Attention U-Net, U-Net++, nnU-Net 등 수많은 후속 모델이 제안되었다. 이러한 발전은 3차원 의료 영상, 자동 모델 구성, 주의(attention) 메커니즘 등으로 확장되었지만, 인코더–디코더 구조와 스킵 연결이라는 핵심 아이디어는 현재까지도 현대 영상 분할 모델의 중요한 기반으로 남아 있다.
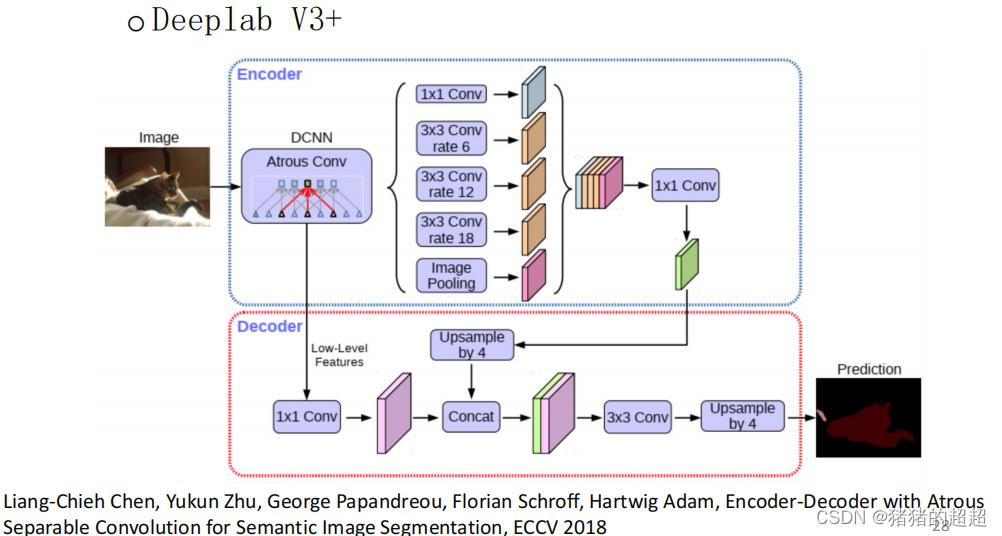
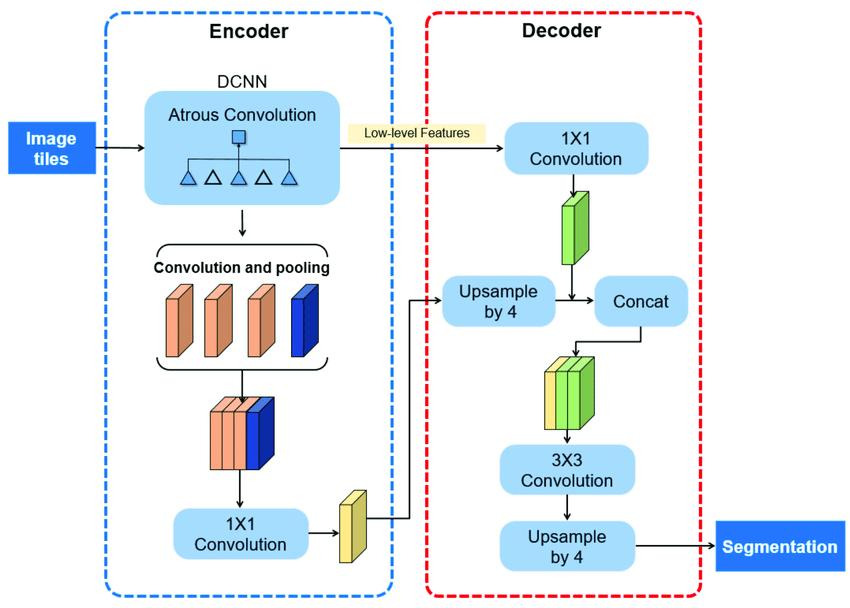
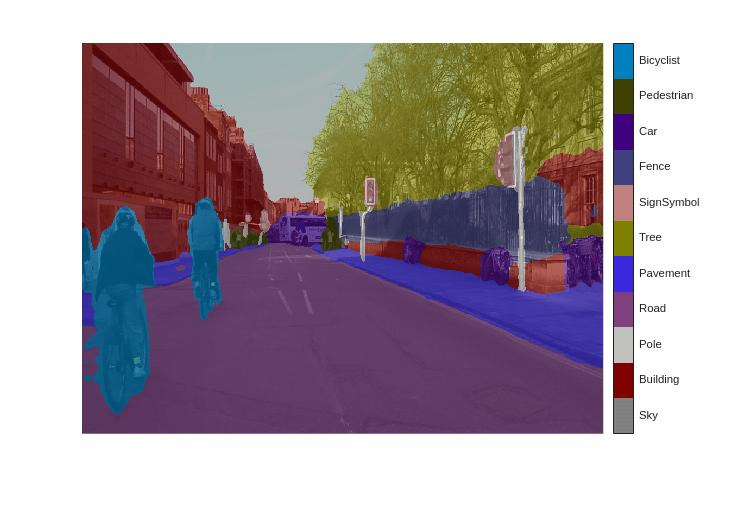
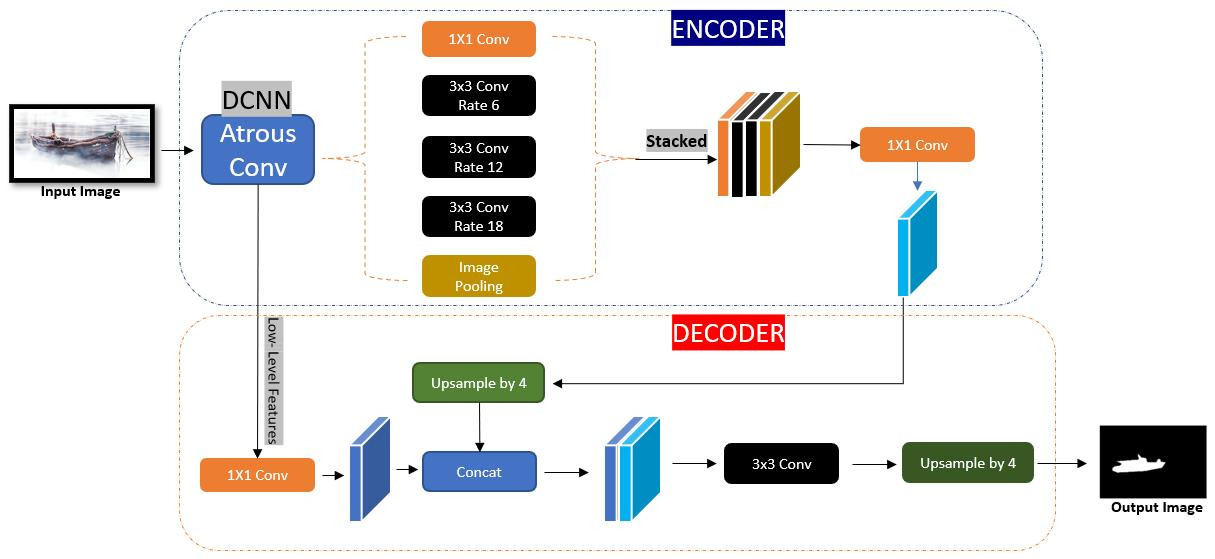
Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation
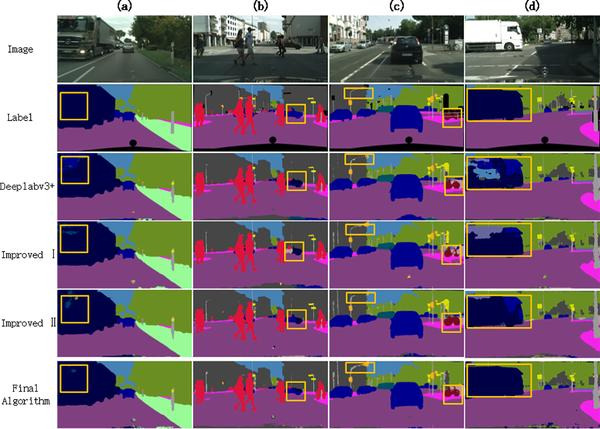
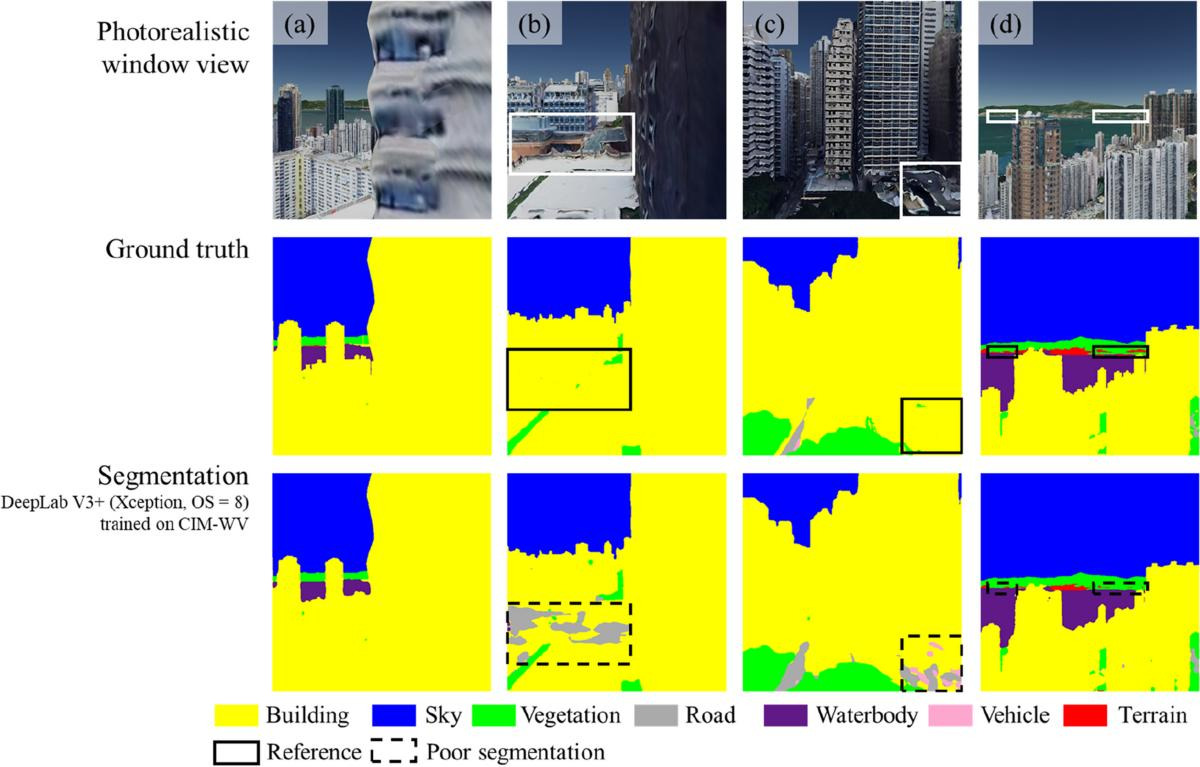
Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation은 2018년 ECCV에서 발표된 **DeepLabV3+**를 소개한 컴퓨터 비전 분야의 대표적인 연구 논문이다. 의미론적 이미지 분할(semantic segmentation)의 정확도와 계산 효율을 동시에 향상시킨 모델을 제안했으며, 이후 다양한 연구와 실제 응용에서 기준점으로 널리 활용되었다. (arXiv)
저자
논문의 주요 저자는 Liang-Chieh Chen, Yukun Zhu, George Papandreou, Florian Schroff, Hartwig Adam이다. Google Research에서 수행된 이 연구는 기존 DeepLab 계열을 발전시켜 **DeepLabV3+**라는 새로운 인코더-디코더 구조를 제안했다. (DBLP)
핵심 내용
논문의 핵심 아이디어는 기존 DeepLabV3의 강점인 Atrous Spatial Pyramid Pooling (ASPP)과 인코더-디코더 구조를 결합하는 것이다. 인코더는 다양한 크기의 문맥 정보를 효과적으로 추출하고, 새롭게 추가된 디코더는 저수준 특징(low-level features)을 활용해 객체 경계를 더욱 정교하게 복원한다. 또한 atrous separable convolution(depthwise separable convolution과 atrous convolution의 결합)을 ASPP와 디코더에 적용해 연산량을 줄이면서도 성능을 높였다. (arXiv)
주요 기여
이 논문은 다음과 같은 공헌으로 잘 알려져 있다.
- DeepLabV3+ 아키텍처 제안
- 멀티스케일 문맥 정보와 정확한 경계 복원을 동시에 달성
- Xception 기반 백본을 개선하여 높은 정확도와 효율성 확보
- PASCAL VOC 2012와 Cityscapes 등 대표적인 벤치마크에서 당시 최고 수준의 성능 달성 (arXiv)
영향
DeepLabV3+는 의미론적 이미지 분할 분야의 가장 영향력 있는 모델 중 하나로 평가된다. 자율주행, 의료영상 분석, 위성영상 처리, 로봇 비전 등 픽셀 단위 객체 인식이 필요한 다양한 분야에서 널리 채택되었으며, 이후의 CNN 기반 및 Transformer 기반 분할 모델과 비교되는 대표적인 기준 모델로 자리 잡았다. (arXiv)
SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers
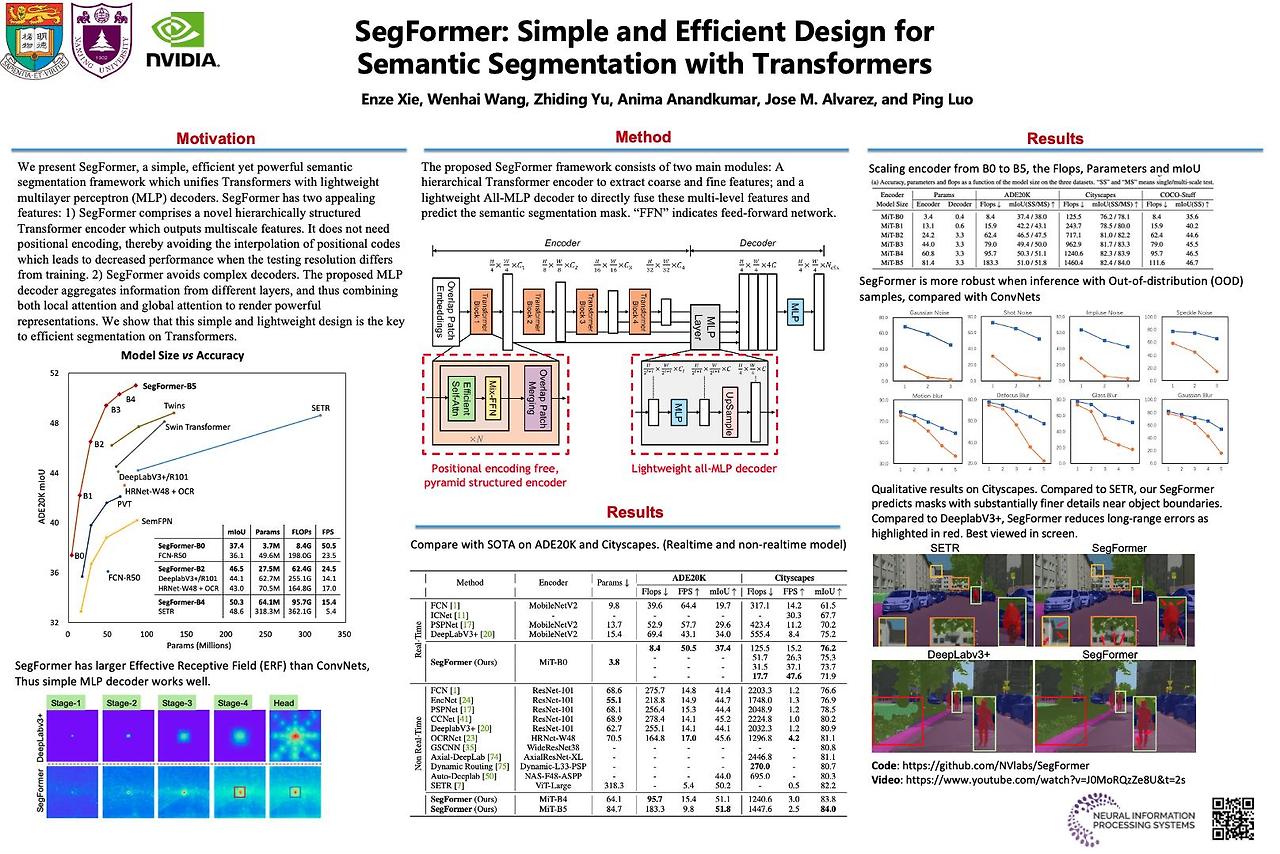
SegFormer: Simple and Efficient Design for Semantic Segmentation with Transformers는 2021년 NeurIPS에 발표된 컴퓨터 비전 연구 논문이다. Transformer 기반 의미론적 분할(semantic segmentation)을 단순하면서도 효율적으로 수행하는 새로운 구조를 제안했으며, 높은 정확도와 계산 효율을 동시에 달성해 이후 비전 모델 설계에 큰 영향을 미쳤다. (NeurIPS Proceedings)
핵심 아이디어
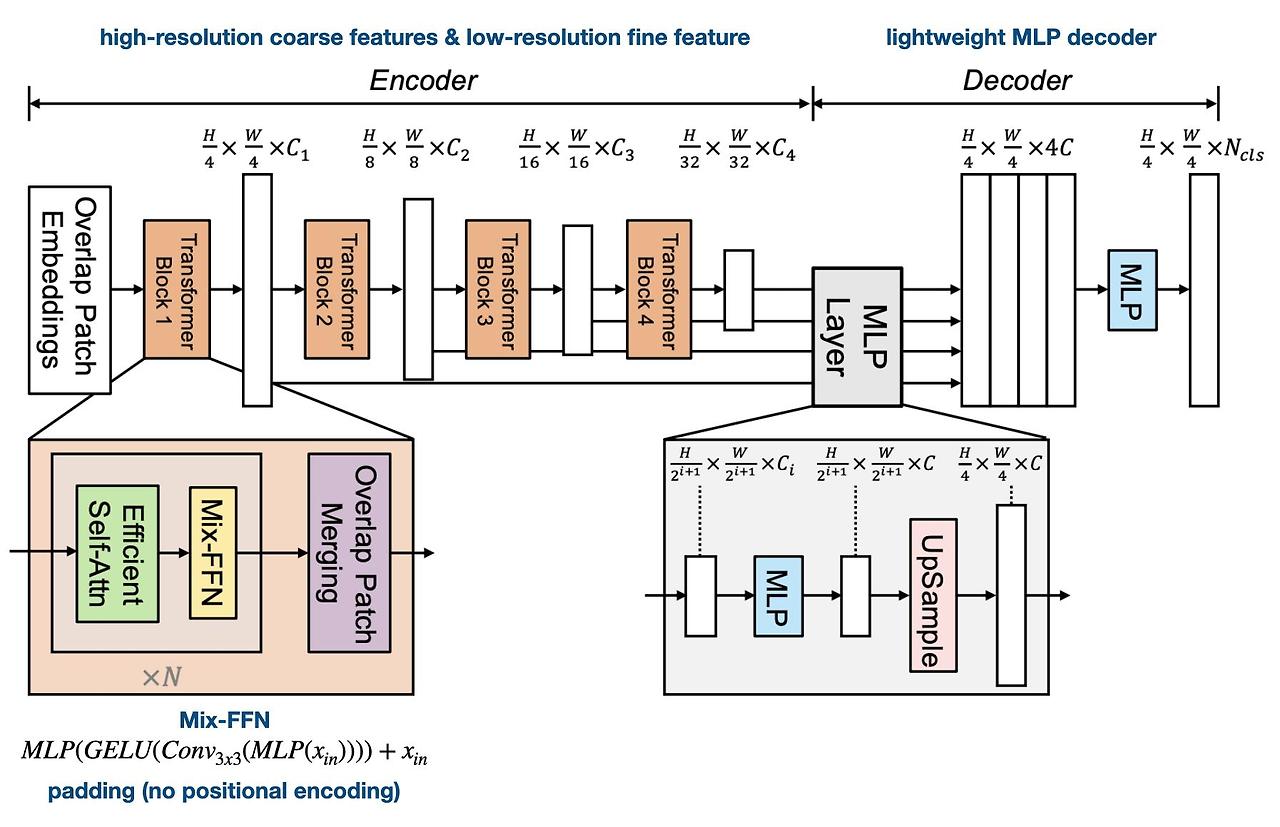
이 논문의 가장 중요한 기여는 계층적 Transformer 인코더와 가벼운 MLP 디코더를 결합한 구조이다. 기존 Transformer 기반 분할 모델들이 복잡한 디코더나 위치 임베딩(positional encoding)에 크게 의존했던 것과 달리, SegFormer는 위치 임베딩을 사용하지 않으면서도 다양한 해상도에서 안정적으로 동작하도록 설계되었다. 또한 여러 계층의 특징(feature)을 단순한 MLP로 융합하여 지역 정보와 전역 정보를 효과적으로 활용한다. (NeurIPS Proceedings)
성능과 영향
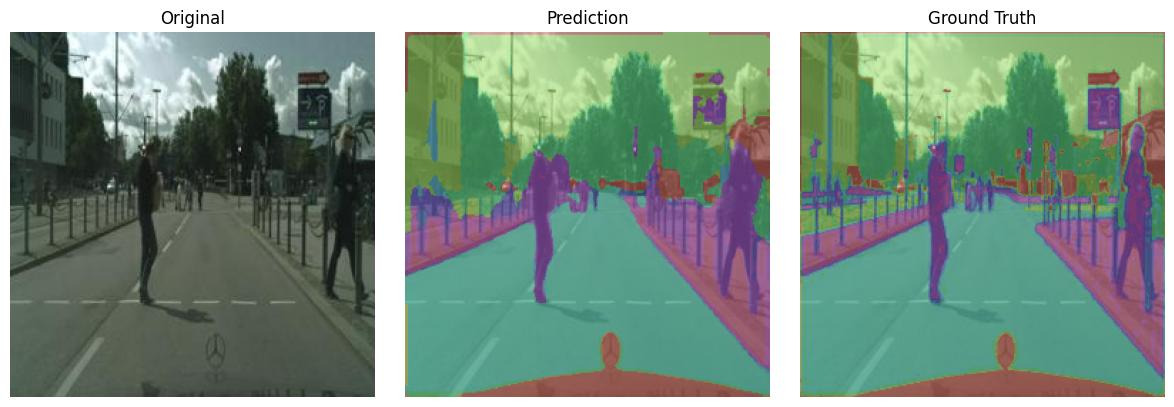
논문에서는 B0부터 B5까지 다양한 크기의 모델을 제시해 정확도와 연산량 사이의 선택지를 제공했다. 발표 당시 SegFormer는 ADE20K와 Cityscapes 같은 대표적인 의미론적 분할 벤치마크에서 이전 Transformer 기반 모델보다 더 적은 매개변수와 계산량으로 경쟁력 있는 성능을 달성했으며, 특히 강인성과 효율성 측면에서 주목받았다. (arXiv)
왜 중요한가
Semantic segmentation은 이미지의 모든 픽셀에 클래스를 부여하는 작업으로, 자율주행, 의료 영상 분석, 로봇 비전 등에 널리 사용된다. SegFormer는 복잡한 설계가 반드시 높은 성능으로 이어지는 것은 아니라는 점을 보여주었으며, 이후의 경량 Transformer 기반 비전 모델과 오픈소스 구현에 큰 영향을 미쳤다. 현재도 연구와 산업에서 강력한 기준선(baseline) 모델 중 하나로 널리 활용된다. (GitHub)
출판 정보
논문의 저자는 Enze Xie, Wenhai Wang, Zhiding Yu, Anima Anandkumar, Jose M. Alvarez, Ping Luo이며, Advances in Neural Information Processing Systems (NeurIPS) 2021에 발표되었다. 원고는 arXiv에서도 공개되어 있으며, 공식 구현은 NVLabs의 PyTorch 저장소를 통해 제공된다. (NeurIPS Proceedings)
LoveDA: A Remote Sensing Land-Cover Dataset for Domain Adaptive Semantic Segmentation
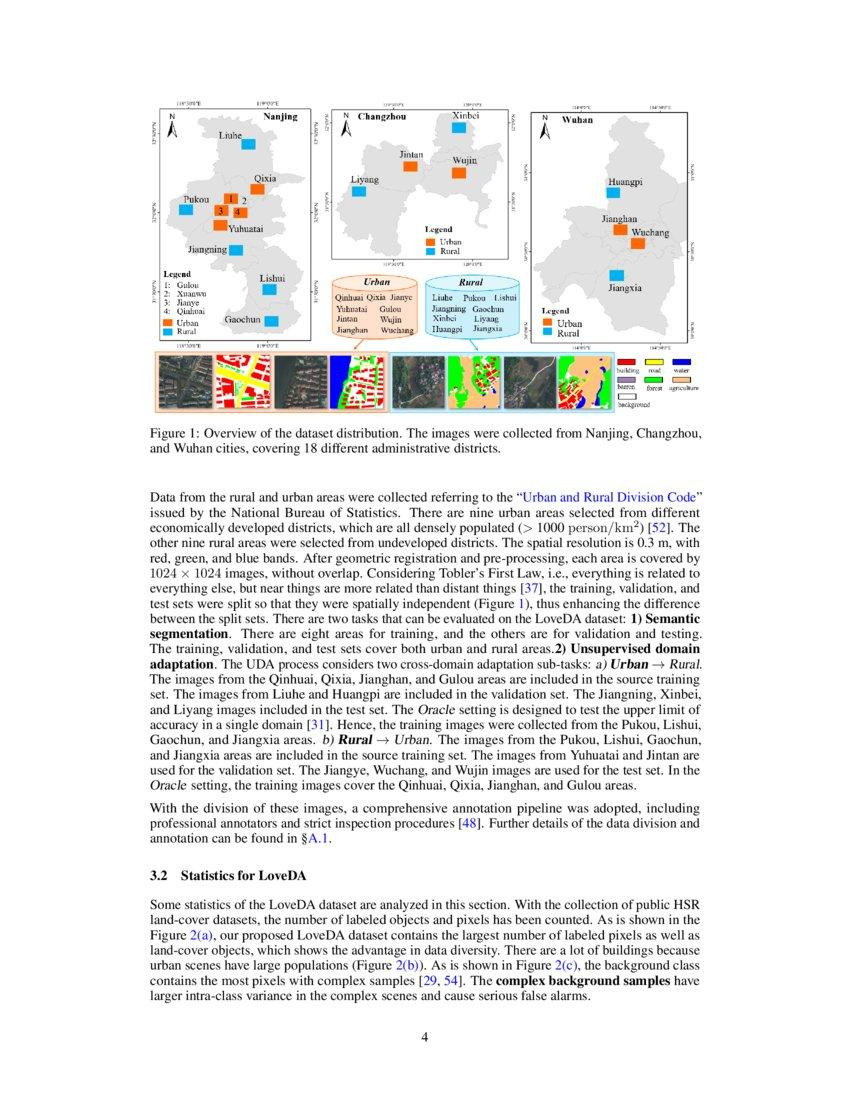
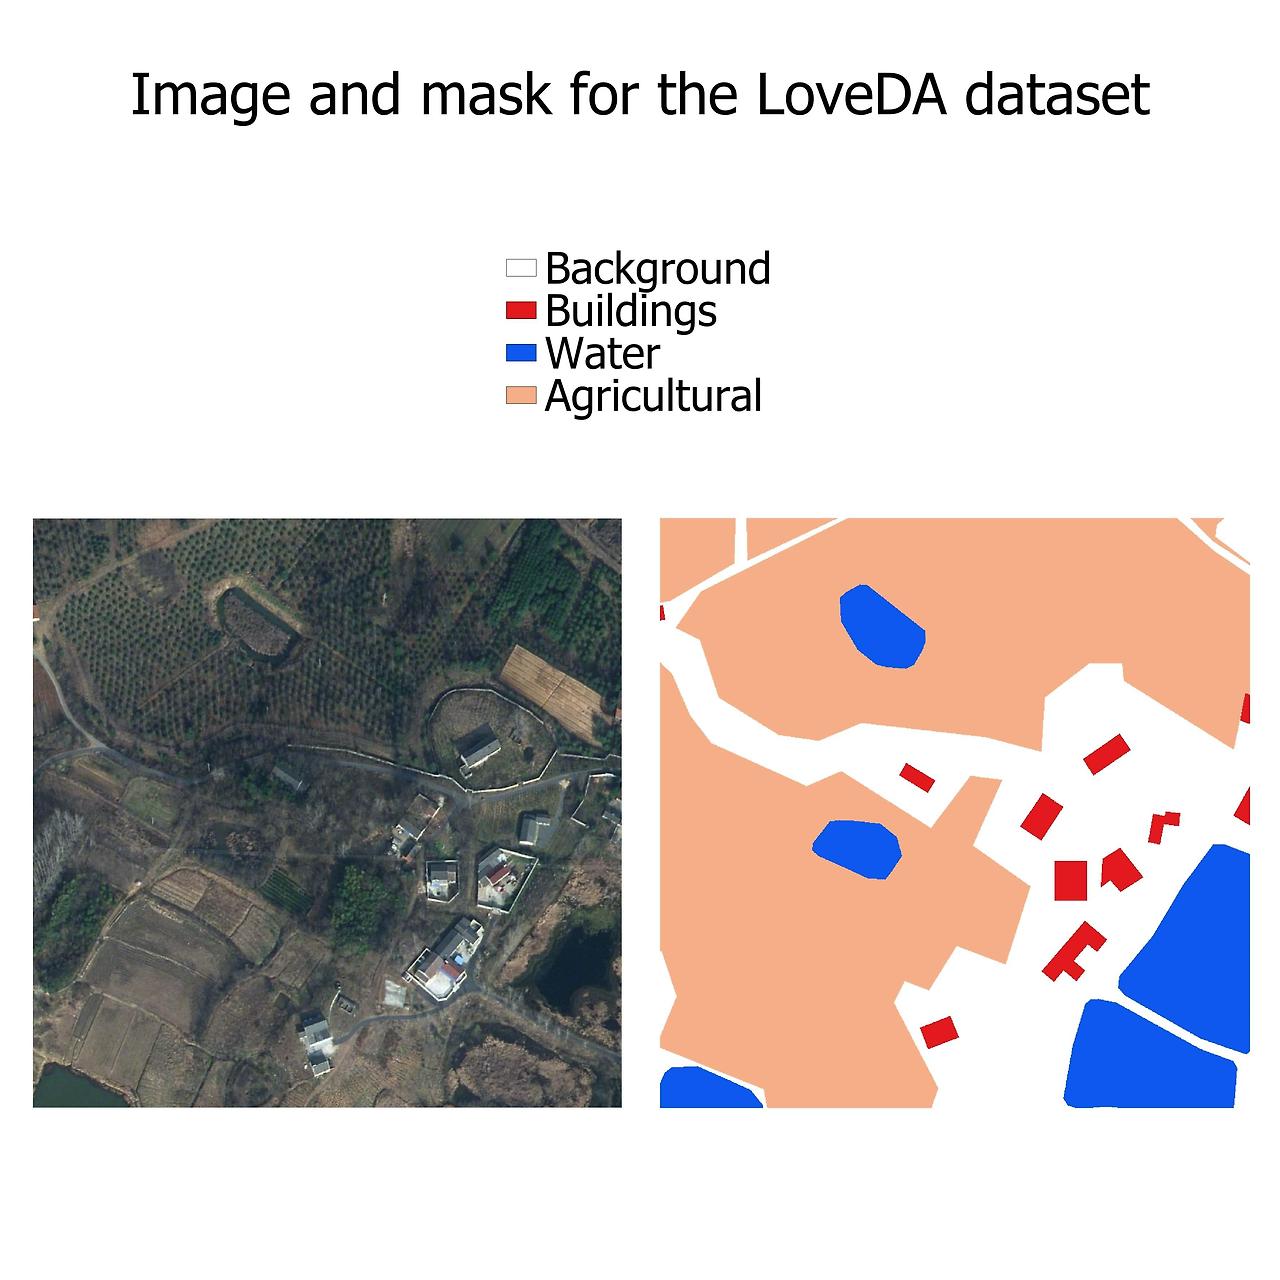
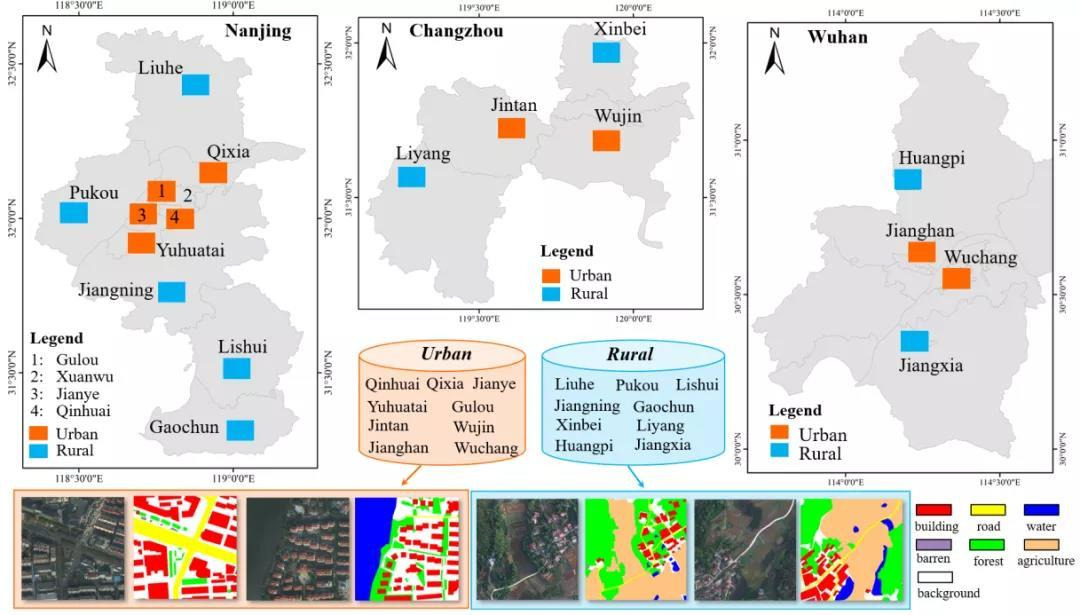
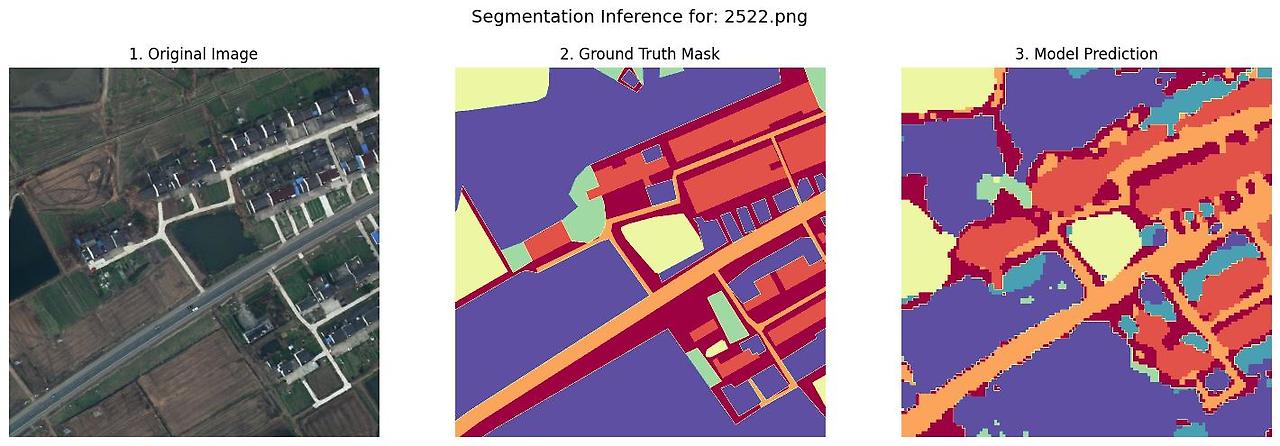
LoveDA: A Remote Sensing Land-Cover Dataset for Domain Adaptive Semantic Segmentation은 원격탐사 영상의 토지피복(land-cover) 의미 분할과 도메인 적응(domain adaptation) 연구를 위해 공개된 데이터셋 및 이를 소개하는 연구 논문이다. 2021년 CVPR Workshop에서 소개된 뒤 NeurIPS Datasets and Benchmarks에도 게재되었으며, 도시와 농촌 간의 분포 차이를 고려한 벤치마크로 널리 활용되고 있다. (arXiv)
핵심 내용
이 논문의 가장 큰 기여는 기존 원격탐사 데이터셋이 주로 단일 환경에서의 의미 분할 성능에 초점을 맞춘 것과 달리, 도시(Urban)와 농촌(Rural)이라는 서로 다른 도메인 간 일반화 능력을 평가할 수 있는 LoveDA 데이터셋을 제안했다는 점이다. 연구진은 이를 통해 단순한 분할 정확도뿐 아니라 비지도 도메인 적응(Unsupervised Domain Adaptation, UDA) 연구를 촉진하는 것을 목표로 했다. (arXiv)
데이터셋 구성
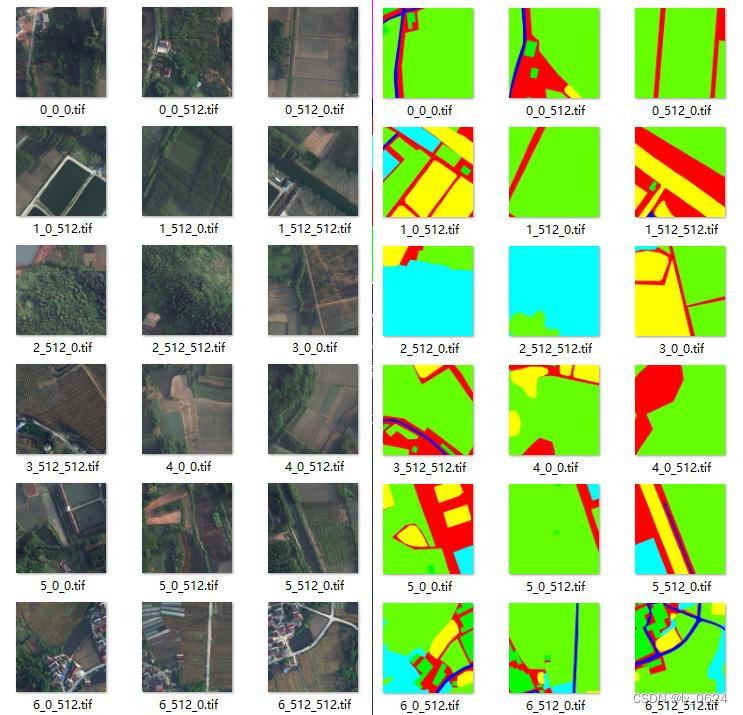
LoveDA는 약 5,987장의 고해상도(0.3 m) 항공·위성 영상과 166,768개의 객체 주석(annotation)을 포함한다. 데이터는 중국의 난징, 창저우, 우한에서 수집되었으며, 도시와 농촌 환경을 모두 포함하도록 설계되었다. 또한 다음과 같은 현실적인 어려움을 반영한다.
- 다양한 크기의 객체(Multi-scale objects)
- 복잡한 배경(Complex backgrounds)
- 도메인별 불균형한 클래스 분포(Inconsistent class distributions)
이러한 특성 덕분에 실제 환경에서 모델의 일반화 성능을 평가하기에 적합한 벤치마크로 자리 잡았다. (GitHub)
연구적 의의
논문에서는 데이터셋 공개와 함께 11개의 의미 분할 모델과 8개의 비지도 도메인 적응 방법을 비교 평가하여 기준 성능(baseline)을 제시했다. 또한 다중 스케일 구조, 배경 감독(background supervision), 의사 라벨(pseudo-label) 활용 등 후속 연구를 위한 다양한 분석도 포함하고 있다. 이러한 벤치마크는 새로운 알고리즘을 동일한 조건에서 비교하는 기준으로 활용되고 있다. (arXiv)
영향
LoveDA는 원격탐사 컴퓨터 비전 분야에서 도메인 적응 기반 의미 분할 연구의 대표적인 공개 데이터셋 중 하나로 인용되고 있으며, 이후 제안된 여러 원격탐사 분할 모델과 UDA 기법의 성능 평가에 사용되고 있다. 특히 실제 운영 환경에서 빈번하게 발생하는 지역·환경 변화에 따른 데이터 분포 차이를 연구하는 데 중요한 역할을 한다. (arXiv)
The ISPRS 2D Semantic Labeling Contest
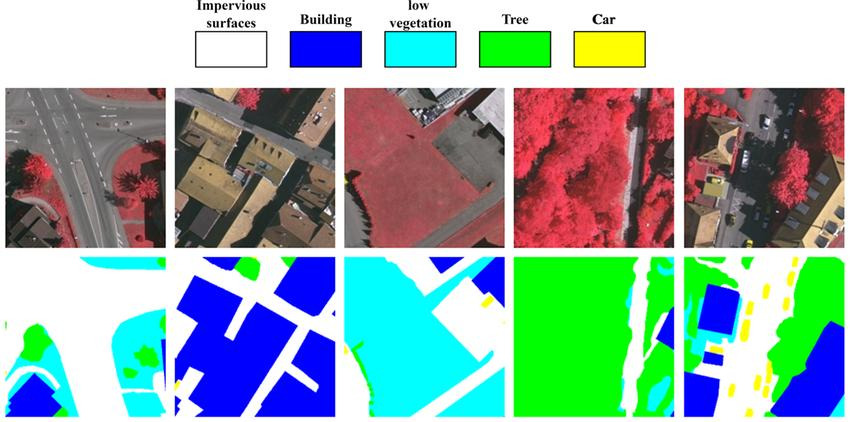
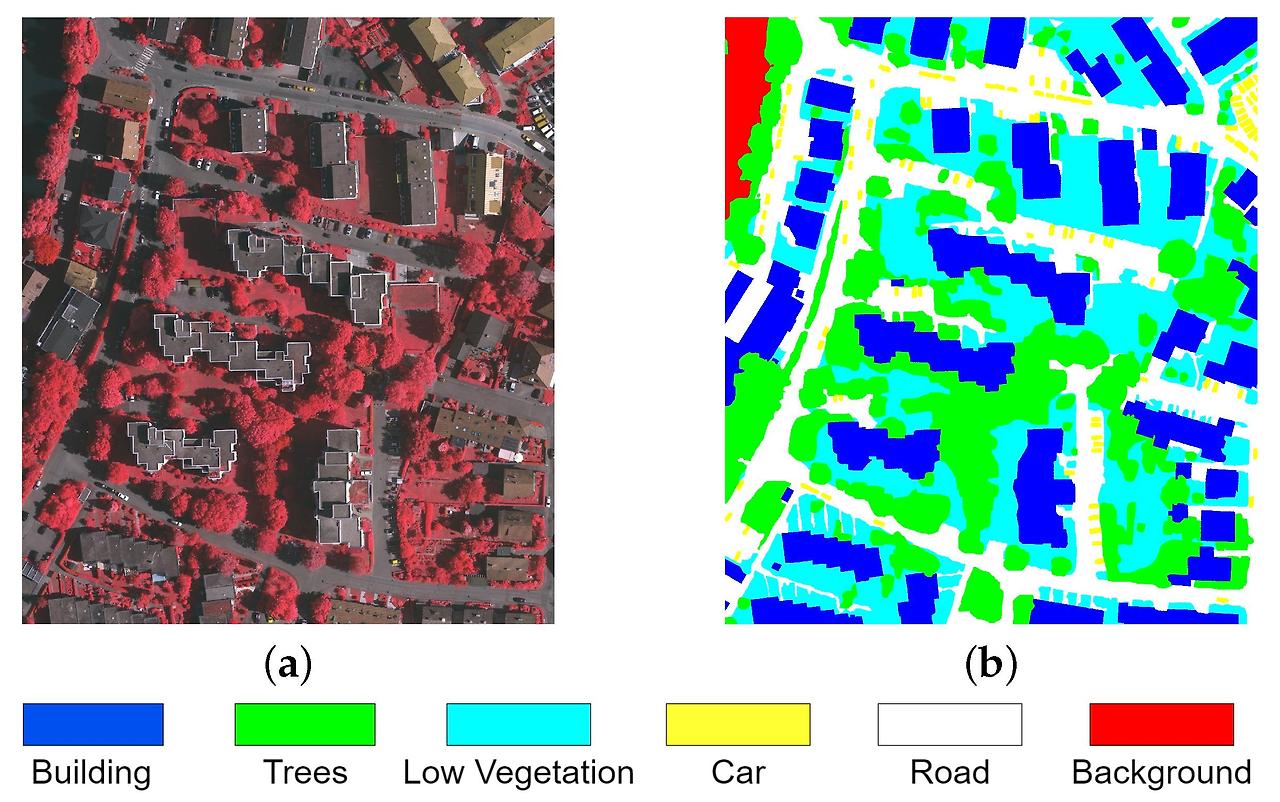
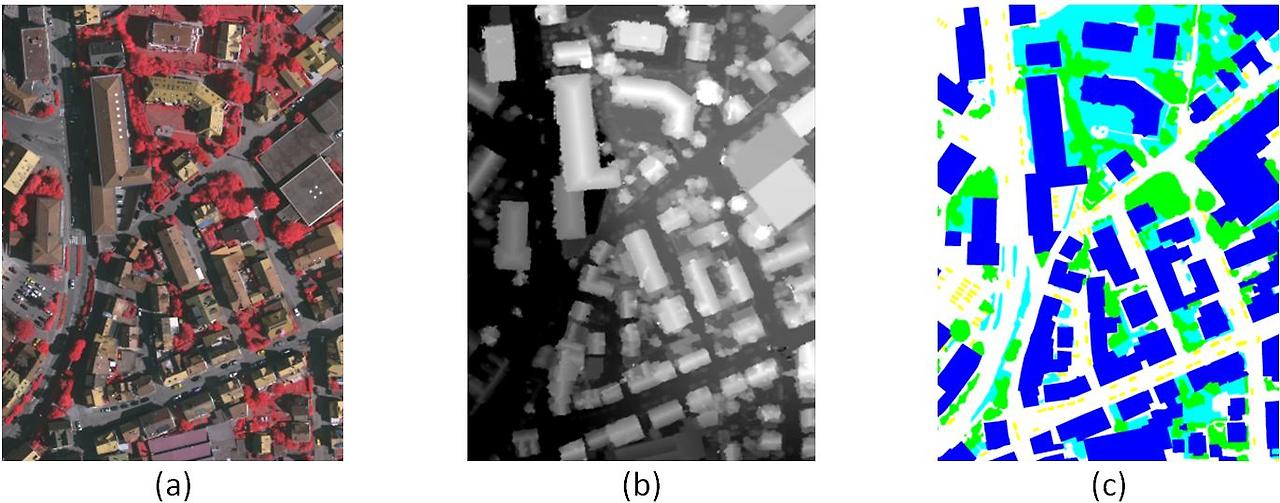
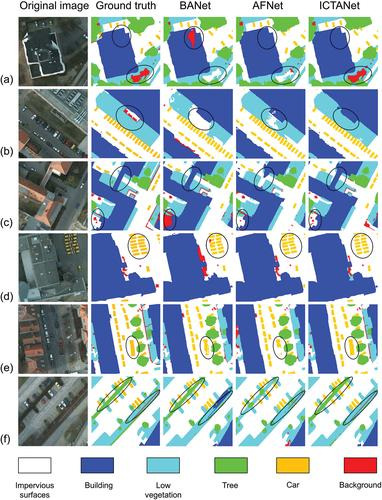
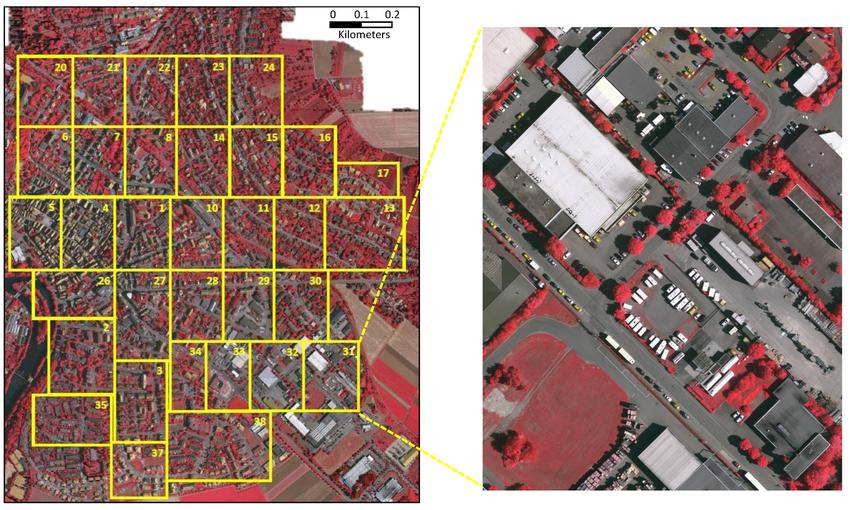
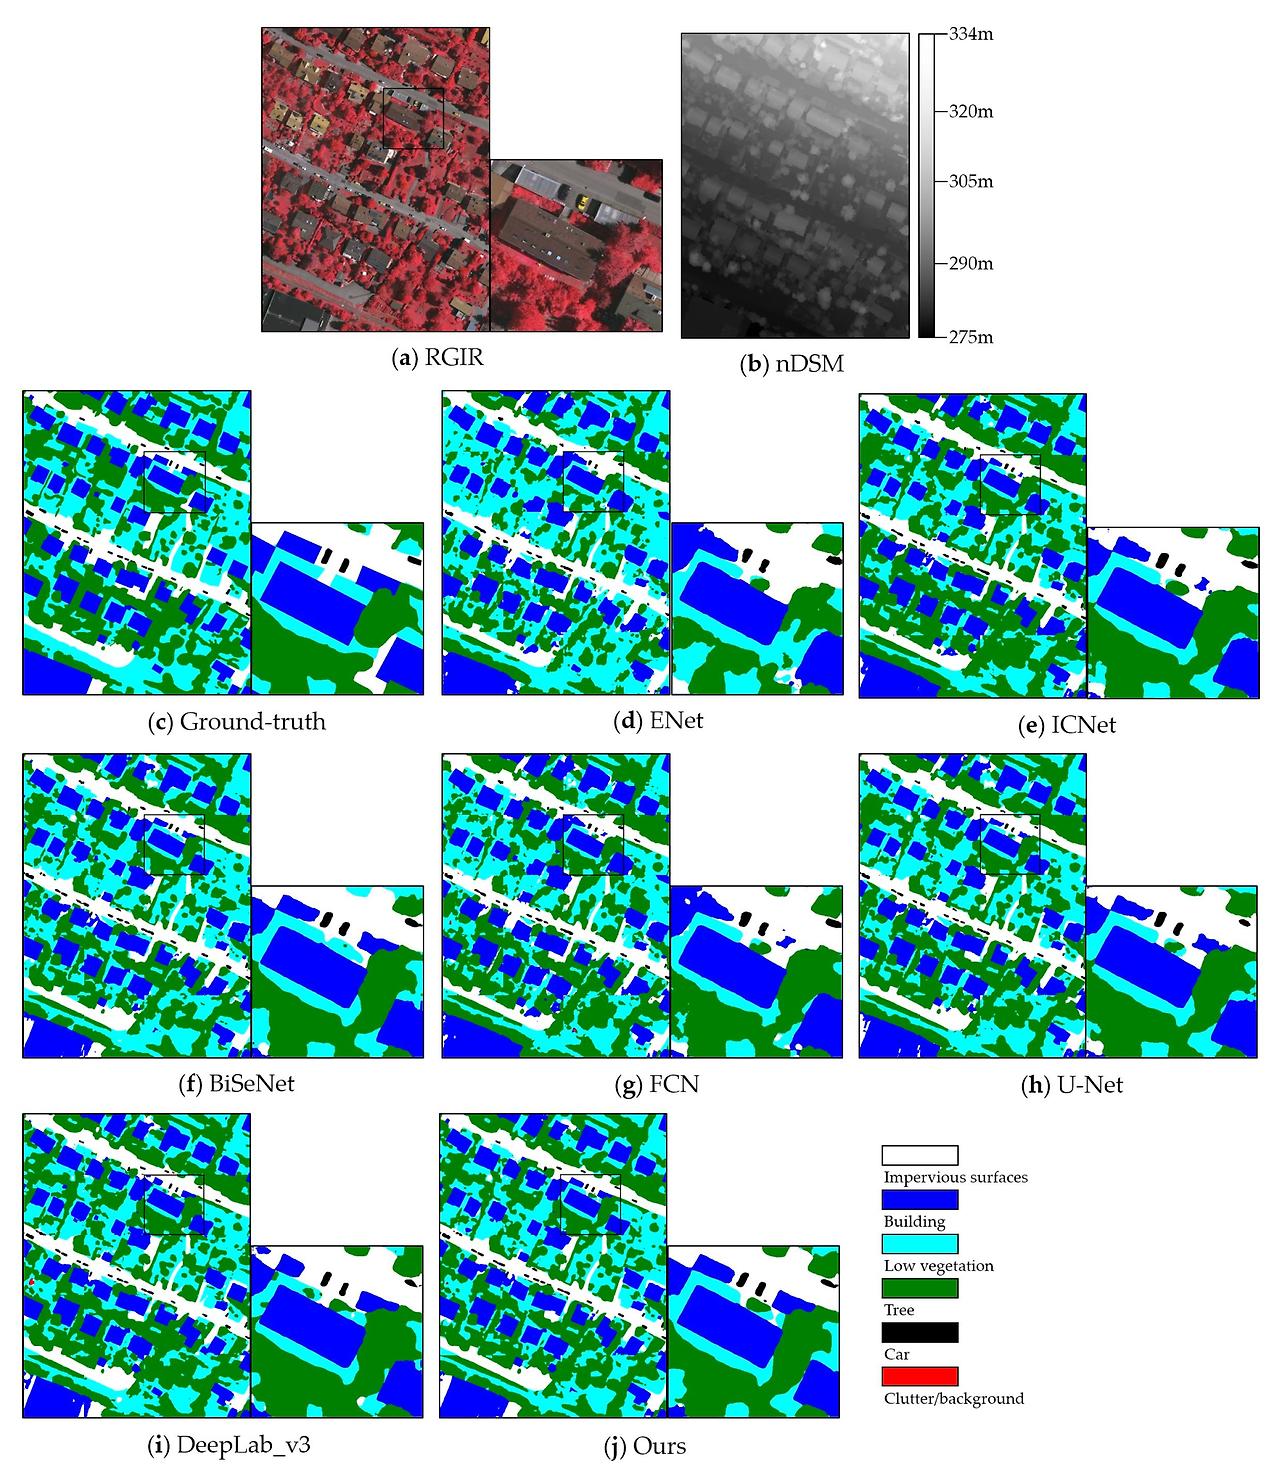
The ISPRS 2D Semantic Labeling Contest는 서적이 아니라, 국제사진측량원격탐사학회(ISPRS)가 운영하는 원격탐사 영상 벤치마크 데이터셋 및 성능 평가 대회이다. 특히 ISPRS Vaihingen/Potsdam Benchmark의 일부로 제공되며, 항공 영상의 픽셀 단위 의미론적 분할(semantic segmentation) 알고리즘을 공정하게 비교·평가하기 위한 표준 데이터셋으로 널리 사용된다. (ISPRS)
목적
이 벤치마크는 매우 높은 해상도의 항공 영상에서 도시 객체를 자동으로 분류하는 연구를 촉진하기 위해 만들어졌다. 연구자들은 동일한 데이터와 평가 기준을 사용하여 건물, 도로, 나무, 자동차 등 다양한 객체를 얼마나 정확하게 분할하는지 비교할 수 있으며, 이는 컴퓨터 비전과 원격탐사 분야의 대표적인 공개 평가 기준 가운데 하나로 자리 잡았다. (ISPRS)
데이터셋 구성
Vaihingen과 Potsdam 두 데이터셋은 다음과 같은 특징을 가진다.
- 정사영상(True Orthophoto)
- DSM(Digital Surface Model, 수치표면모델)
- 일부 타일에 대한 정답(ground truth) 라벨
- 나머지 테스트 데이터는 비공개로 유지되어 공정한 성능 평가에 사용됨
Potsdam 데이터는 5 cm 공간해상도의 38개 패치로 구성되며, RGB, IRRG, RGBIR 영상과 DSM을 제공한다. Vaihingen 데이터는 33개의 패치와 DSM으로 구성되어 있다. (ISPRS)
의미론적 클래스
대표적으로 다음과 같은 도시 객체를 픽셀 단위로 분류한다.
- 불투수면(도로·포장면)
- 건물
- 저층 식생
- 나무
- 자동차
- 배경(Clutter/Background)
이러한 클래스는 도시 지도 제작, 토지 피복 분석, 스마트 시티 연구 등 다양한 응용 분야에서 활용된다. (GitHub)
영향
ISPRS 2D Semantic Labeling Contest는 딥러닝 기반 의미론적 분할 연구에서 가장 많이 인용되는 공개 벤치마크 중 하나이다. FCN, U-Net 계열, Attention 기반 모델, Transformer 기반 모델 등 수많은 최신 알고리즘이 Vaihingen 및 Potsdam 데이터셋에서 성능을 보고하며 비교되어 왔으며, 오늘날에도 원격탐사 영상 분할 연구의 기준 데이터셋으로 널리 활용되고 있다. (arXiv)
Conditional Random Fields as Recurrent Neural Networks
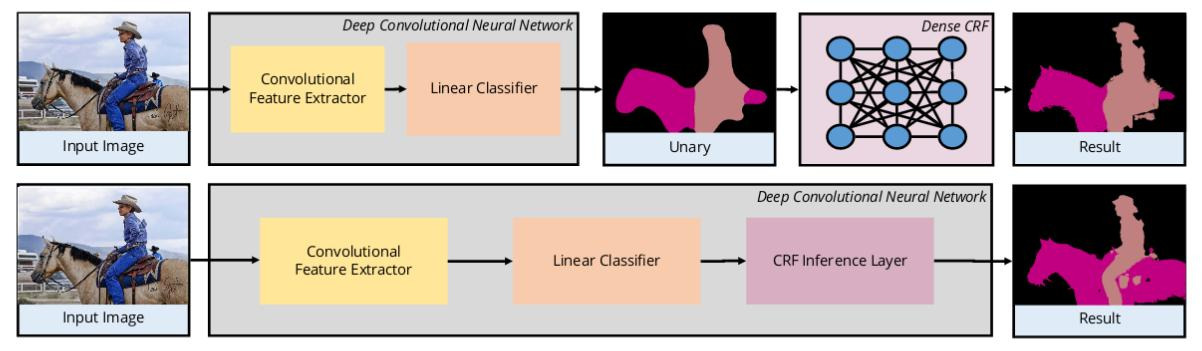
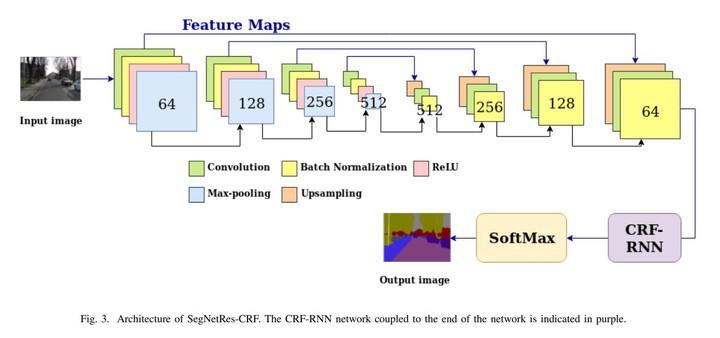
Conditional Random Fields as Recurrent Neural Networks는 2015년 ICCV에서 발표된 컴퓨터 비전 연구 논문으로, 의미론적 분할(semantic segmentation)을 위한 CRF(Conditional Random Field) 추론을 순환 신경망(RNN) 형태로 구현한 방법을 제안했다. 이 연구는 전통적인 확률 그래프 모델과 딥러닝을 하나의 학습 가능한 네트워크로 통합했다는 점에서 큰 영향을 미쳤으며, 이후의 영상 분할 연구에 널리 인용되는 대표적인 작품이다.
핵심 아이디어
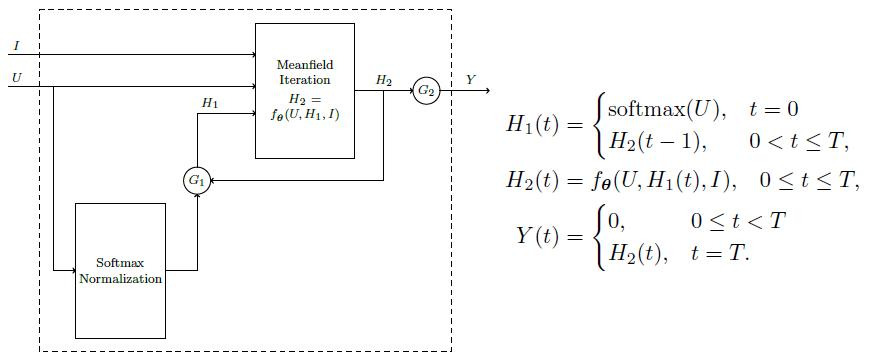
기존 의미론적 분할 시스템은 CNN이 픽셀별 예측을 수행한 뒤, 별도의 Dense CRF 후처리로 경계를 다듬는 방식이 일반적이었다. 이 논문은 평균장(mean-field) 추론의 반복 과정을 RNN의 시간 단계로 해석하여 네트워크 내부에 포함시켰으며, 이를 통해 end-to-end 학습이 가능함을 보여주었다.
주요 기여
이 접근법의 핵심은 확률 그래프 모델의 구조적 제약과 심층 신경망의 표현력을 동시에 활용하는 데 있다. CRF 추론 과정이 미분 가능하도록 구성되어 역전파가 가능하며, CNN이 생성한 거친 분할 결과를 객체 경계와 지역적 일관성을 고려해 더욱 정교하게 보정할 수 있었다.
영향과 의의
이 논문은 딥러닝과 구조적 예측(structured prediction)을 결합하는 대표적인 사례로 평가된다. 이후 등장한 다양한 의미론적 분할 모델들은 CRF를 직접 사용하지 않는 경우가 많아졌지만, 전통적인 최적화 알고리즘을 신경망 계층으로 변환하는 발상은 후속 연구에 큰 영향을 주었으며, 딥 언롤링(deep unfolding) 및 모델 기반 딥러닝 분야의 발전에도 중요한 사례로 자주 인용된다.
저자 및 연구 배경
논문의 대표 저자는 Shuai Zheng, Sadeep Jayasumana, Bernardino Romera-Paredes, Vijay Vineet, Zhizhong Su, Dalong Du, Chang Huang, Philip H. S. Torr이다. 연구는 당시 빠르게 발전하던 완전합성곱신경망(FCN) 기반 의미론적 분할의 한계를 해결하기 위해 제안되었으며, CNN과 CRF를 하나의 학습 가능한 모델로 결합한 대표적인 이정표로 남아 있다.
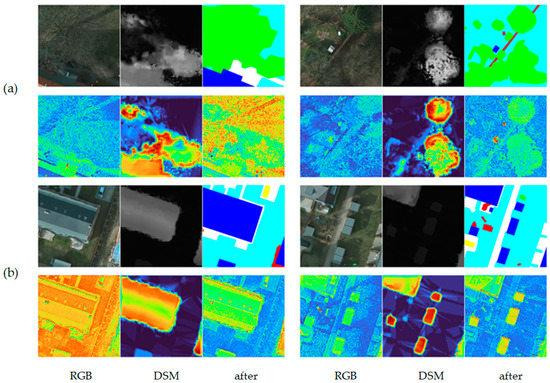
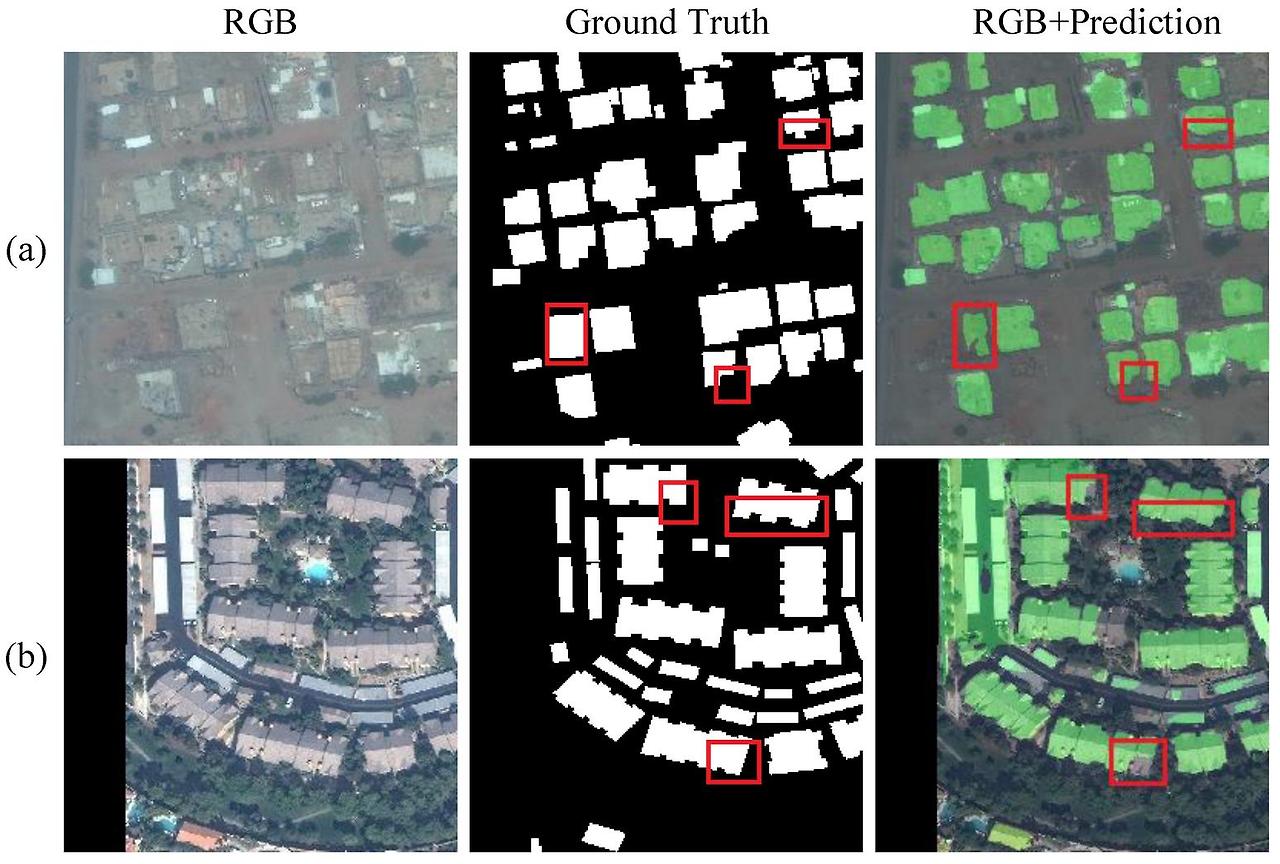
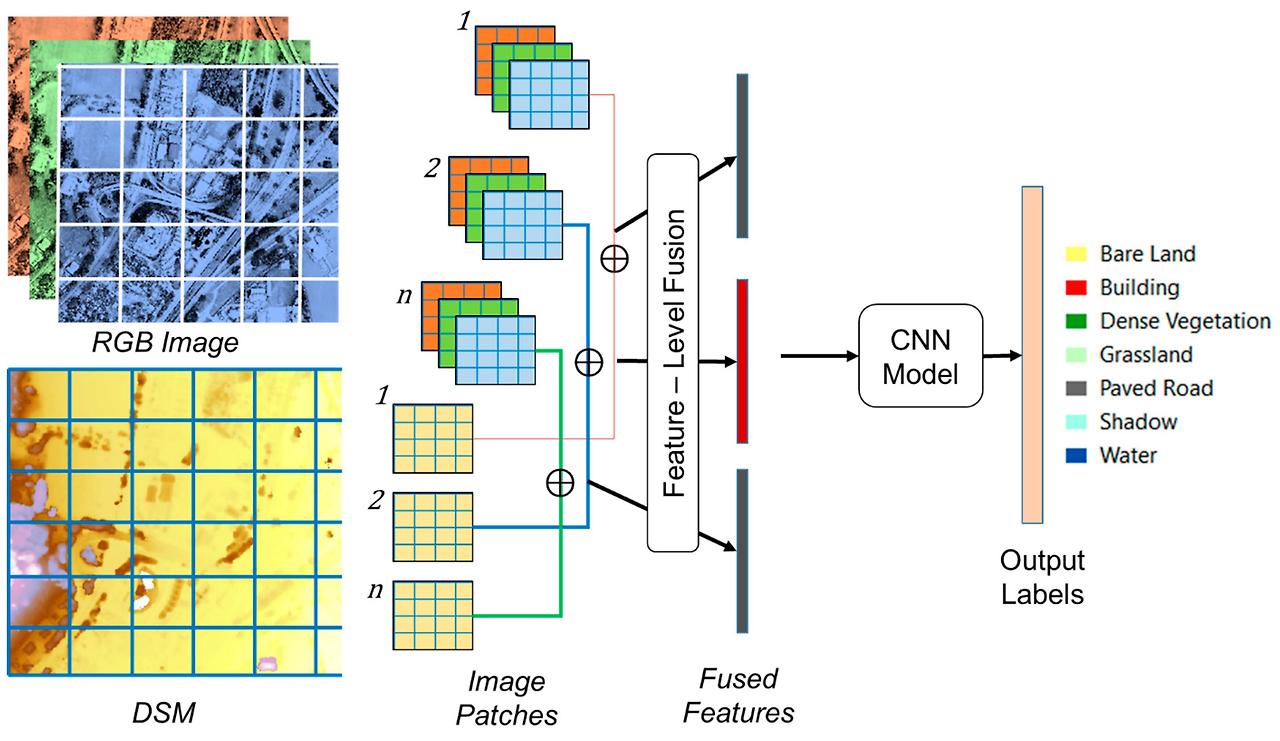
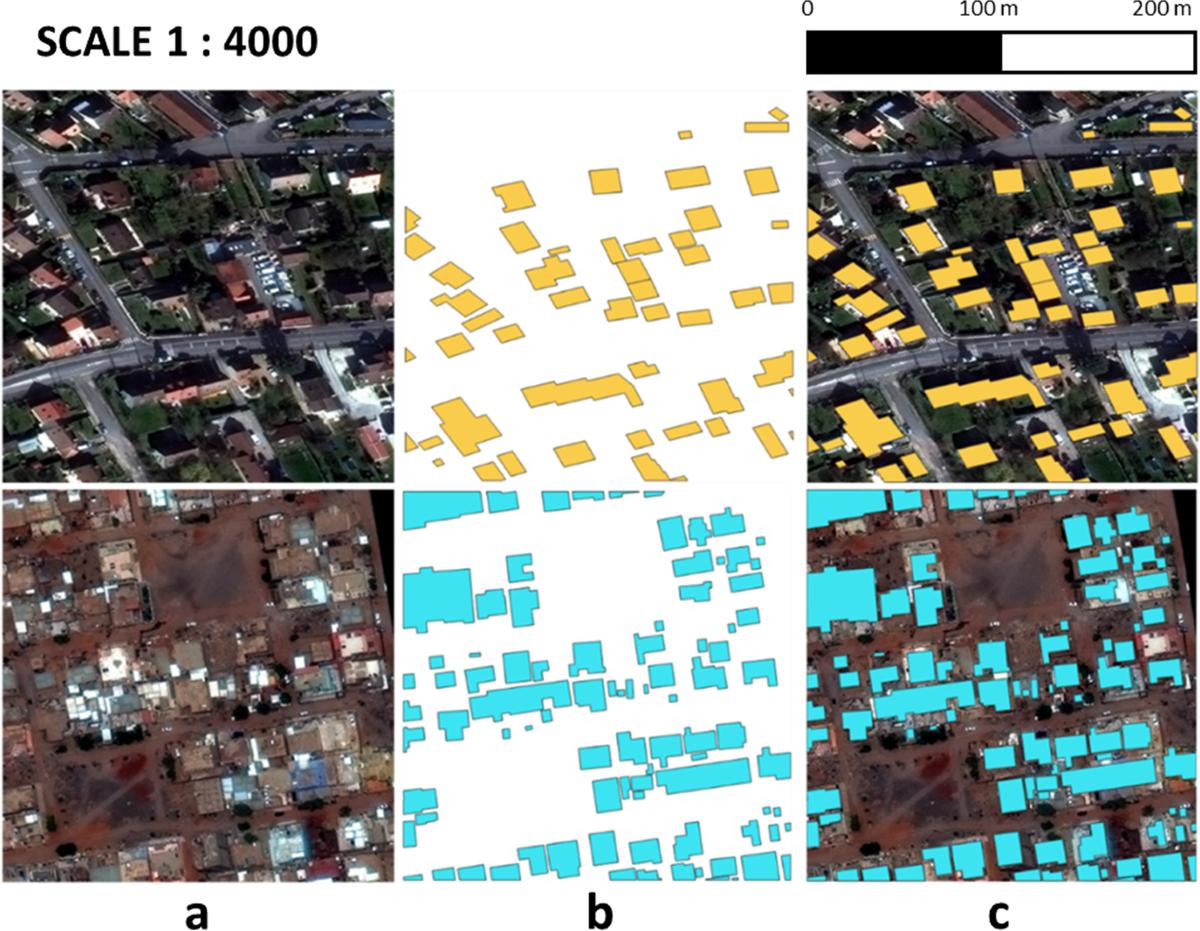
CMGFNet
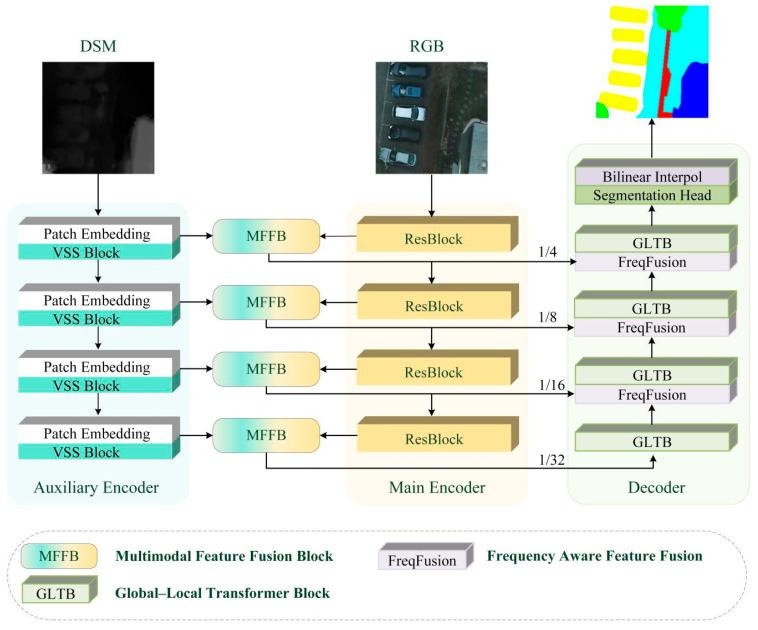
CMGFNet: A deep cross-modal gated fusion network for building extraction from very high-resolution remote sensing images는 초고해상도(VHR) 원격탐사 영상과 DSM(Digital Surface Model)을 함께 사용하는 멀티모달 시맨틱 분할 연구 논문이다. RGB-DEM(RGB-DSM) 융합을 위한 게이트 기반(cross-modal gated) 특징 융합 구조를 제안했으며, 2022년 ISPRS Journal of Photogrammetry and Remote Sensing에 게재되어 RGB-DEM 융합 연구에서 자주 인용되는 모델 중 하나이다. (트벤테 대학교 연구 정보)
연구 목적
이 논문의 핵심 목표는 RGB 영상의 풍부한 질감 정보와 DSM의 높이 정보를 효과적으로 결합하여 건물 추출(Building Extraction)의 정확도를 높이는 것이다.
기존 RGB 단독 모델은 건물과 도로의 색상이 비슷하면 오분류가 발생하기 쉽고, DSM 단독 모델은 노이즈와 낮은 품질 때문에 경계가 불명확해질 수 있다. CMGFNet은 두 모달리티의 장점을 선택적으로 활용하도록 설계되었다. (ScienceDirect)
핵심 구조
CMGFNet의 가장 중요한 구성 요소는 다음 세 가지이다.
- Dual Encoder
- RGB와 DSM을 각각 독립적인 인코더(ResNet-34 기반)에서 특징 추출
- Gated Fusion Module (GFM)
- RGB 특징이 DSM 특징을 보완하고, 반대로 DSM도 RGB 특징을 보완하도록 게이트(gate)를 이용해 정보의 중요도를 학습
- 단순 concat이나 add보다 불필요한 정보를 억제하는 역할을 수행
- Multi-level Feature Fusion + R-DSC Decoder
- 깊은 semantic feature와 얕은 spatial feature를 함께 사용
- Residual-like Depthwise Separable Convolution(R-DSC)을 적용하여 연산량을 줄이면서 복원 성능을 향상시켰다. (트벤테 대학교 연구 정보)
RGB-DEM(DSM) 융합 관점에서의 의미
CMGFNet은 RGB-DEM 융합 연구에서 다음과 같은 흐름을 대표하는 모델이다.
- Early Fusion이 아닌 Feature-level Fusion
- Cross-modal Interaction을 명시적으로 수행
- Attention 이전 세대의 Gate 기반 선택적 융합
- RGB와 DSM의 특징을 동일하게 취급하지 않고 신뢰도에 따라 가중치를 조절하는 구조
이러한 접근은 이후 Transformer 기반 RGB-X 융합 모델과 게이트·어텐션 결합 방식의 연구에도 영향을 주었다. (ScienceDirect)
성능 및 평가
논문은 ISPRS Potsdam, ISPRS Vaihingen, 그리고 USGS 데이터셋에서 실험을 수행했으며, 당시의 여러 대표적인 FCN 기반 모델(SegNet, PSPNet, DeepLabv3+ 등)과 비교하여 건물 추출 정확도를 향상시켰다고 보고했다. 또한 Gated Fusion Module, Multi-level Fusion, R-DSC 각각의 기여도를 확인하기 위한 ablation study도 함께 제시하였다. (트벤테 대학교 연구 정보)
RGB-DEM Semantic Segmentation 연구에서의 위치
CMGFNet은 RGB-DEM(또는 RGB-DSM) 융합을 위한 CNN 기반 대표 모델로 평가된다. 이후 등장한 Transformer 기반 RGB-X 모델들과 비교하면 다음과 같은 특징이 있다.
항목CMGFNet
| Backbone | CNN (ResNet-34) |
| 입력 | RGB + DSM(DEM 계열) |
| Fusion 방식 | Cross-modal Gated Fusion |
| Decoder | Multi-level + R-DSC |
| 주요 응용 | Building Extraction |
| 의의 | RGB-DEM 게이트 기반 융합 구조를 체계적으로 제안한 대표 연구 |
현재는 Transformer나 Mamba 기반 멀티모달 모델들이 성능 면에서 발전했지만, 게이트를 이용한 RGB-DEM 특징 융합이라는 아이디어는 여전히 후속 연구에서 중요한 설계 요소로 활용되고 있다. (mdpi.com)
'석사 학위 논문 > ETC' 카테고리의 다른 글
| 연구 주제 정리 (0) | 2026.07.22 |
|---|---|
| 연구 질문 (0) | 2026.07.20 |
| 논문 리뷰할 때 필수 질문 목록 (0) | 2026.07.20 |
| 최종 연구 주제 후보 선정 1 (0) | 2026.07.20 |